Er folgt der Stimme, nicht einem festen Pegel
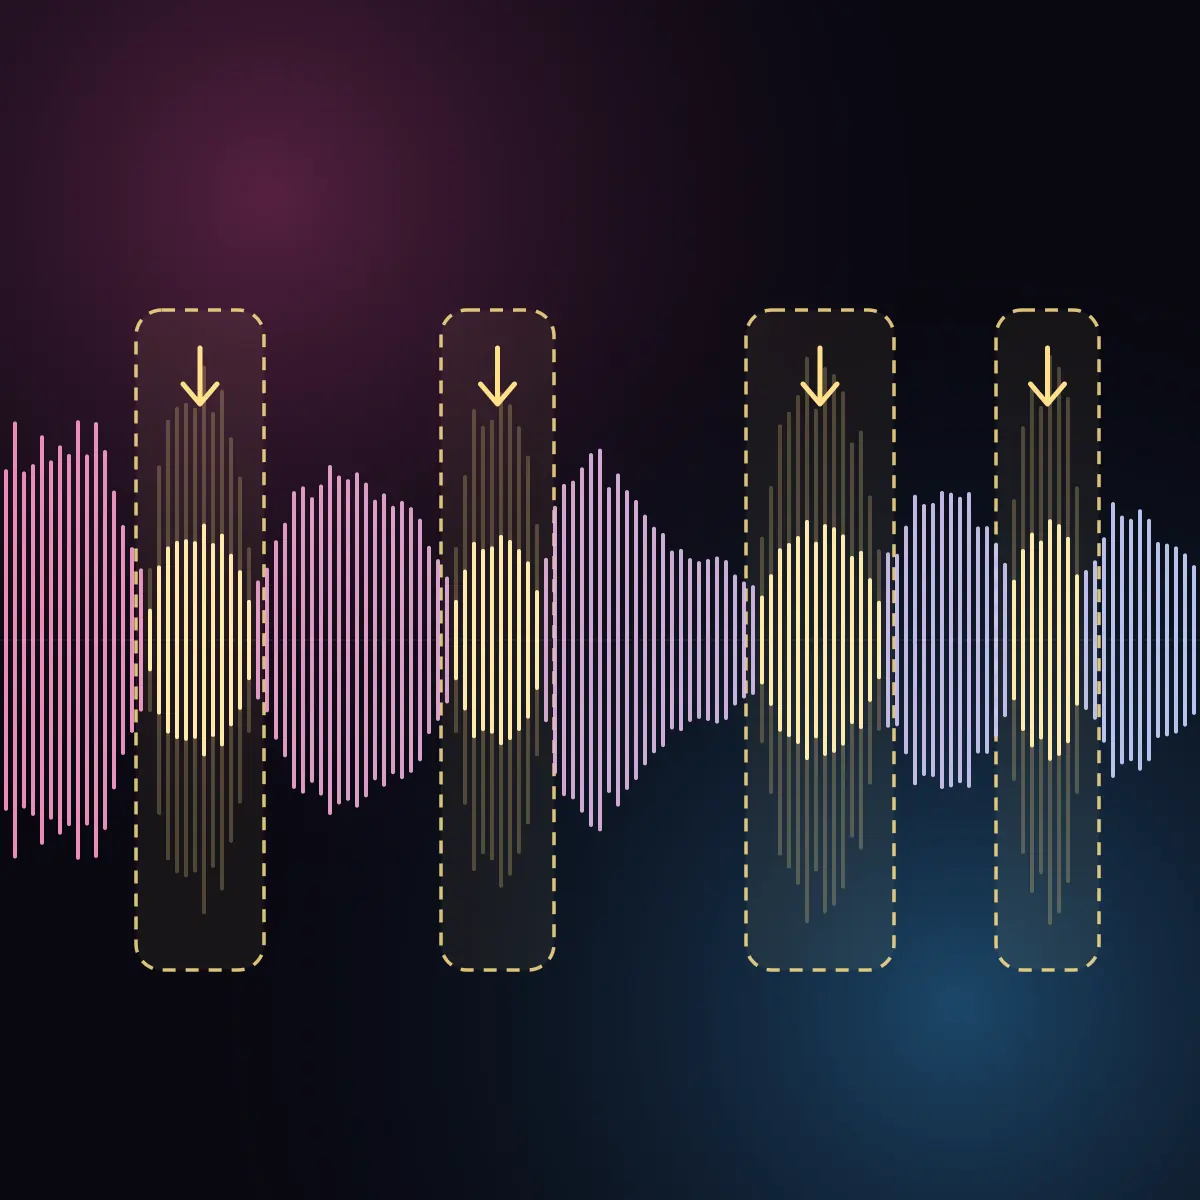
Der De-Esser vergleicht jedes „s“ mit der Stimme drumherum. Eine leise Strophe und ein lauter Refrain werden gleich behandelt, und du stellst keinen Schwellenwert ein.
Kostenloses Audio-Tool
Lade Vocals, einen Podcast oder ein Voice-over hoch. Der De-Esser senkt die scharfen Laute „s“, „sch“ und „z“ ab, und der Rest der Stimme behält seinen Klang. Vergleiche jede Datei mit dem Original und lade dann die WAV-Datei herunter.
De-Esser
Für Lead-Vocals, Backing-Vocals, Rap, Podcasts, Voice-over und Sprache. Jede Datei kommt als WAV in ihrer eigenen Samplerate zurück.
Der De-Esser vergleicht jedes „s“ mit der Stimme drumherum. Eine leise Strophe und ein lauter Refrain werden gleich behandelt, und du stellst keinen Schwellenwert ein.
Ein weiches „s“ wird nur leicht abgesenkt. Ein „s“, das gegenüber den Vokalen davor scharf klingt, wird stärker abgesenkt – in den Höhen, wo die Schärfe sitzt.
Jede Datei bekommt ihren eigenen Player. Schalte während der Wiedergabe zwischen Original und bearbeiteter Version um und sieh, wo jedes „s“ abgesenkt wurde.
Ein helles Mikrofon, eine nahe Aufnahme, ein Kompressor oder eine Höhenanhebung können „s“, „sch“ und „z“ scharf machen. Ein Equalizer, der sie absenkt, macht auch die ganze Stimme dumpf. Der De-Esser senkt die Höhen nur ab, solange ein solcher Laut dauert.
Glätte die Zischlaute von Lead-Vocals oder Backing-Vocals vor dem Mix.
Mach Sprache angenehmer zu hören, auch über Kopfhörer.
Bearbeite zuerst die Vocal-Spuren mit dem De-Esser. Dann kannst du sie komprimieren und aufhellen, ohne dass die S-Laute scharf werden.
Wähle Leicht, Mittel oder Stark und füge dann bis zu 5 Dateien in einem Durchgang hinzu. Jede Datei darf bis zu 20 Minuten lang sein.
Der De-Esser liest jede Datei tausendmal pro Sekunde, findet die S-Laute und senkt die Höhen ab, solange jeder einzelne dauert.
Spiel jede Datei ab, schalte zwischen Original und bearbeiteter Version um und lade die WAV-Datei herunter.
Jede Datei kommt als WAV zurück, mit derselben Länge, Samplerate und Kanalzahl wie dein Upload.
Was er macht, welche Dateien er annimmt und wo seine Grenzen liegen.
Er senkt Zischlaute (Sibilanten) ab: die scharfen Laute „s“, „sch“, „z“ und „t“ einer Stimme. Er senkt die Höhen der Stimme nur ab, solange ein solcher Laut dauert, und so behält die Stimme ihre Brillanz.
Eine Stimme auf ihrer eigenen Spur: Lead-Vocals, Backing-Vocals, Rap, Podcasts, Voice-over und Sprache. WAV, AIFF, FLAC, MP3, M4A und andere gängige Audiodateien, jeweils bis zu 20 Minuten und 1 GB, mit einer Samplerate von 32 kHz oder mehr.
Fang mit Mittel an. Wähle Leicht für eine Stimme, die nur wenig braucht. Wähle Stark für helle oder stark komprimierte Vocals mit scharfen S-Lauten. Eine Einstellung gilt für alle Dateien eines Durchgangs.
Der De-Esser ist für eine Stimme auf ihrer eigenen Spur gemacht. Bei einem ganzen Song senkt er auch Becken, Hi-Hats und andere helle Klänge ab. Bei einem Song bearbeitest du die Vocal-Spur vor dem Mix mit dem De-Esser.
Die Höhen der Stimme, solange ein S-Laut dauert, und für einen Moment danach. Die Vokale und der Körper der Stimme bleiben, wie sie sind. Die Datei behält ihre Länge, ihre Samplerate und ihre Kanäle.
Der De-Esser senkt nur ab, solange ein S-Laut dauert. Dazwischen bleibt die Stimme hell. Wenn die S-Laute zu weich werden, nimm eine leichtere Einstellung.
Einen Durchgang pro Woche, mit bis zu 5 Dateien. Du brauchst kein Konto. Mit einem Abo fällt das Wochenlimit weg.
Eine WAV-Datei in der Samplerate deines Uploads: 24 Bit oder 32-Bit-Float, wenn dein Upload eine Float-Datei ist. Der Player auf der Seite nutzt eine AAC-Vorschau mit 256 kbps. Der Download ist die Datei in voller Qualität.
Lade deine Dateien hoch, hör dir den Unterschied an und lade die bearbeitete WAV-Datei herunter.