Sigue a la voz, no a un nivel fijo
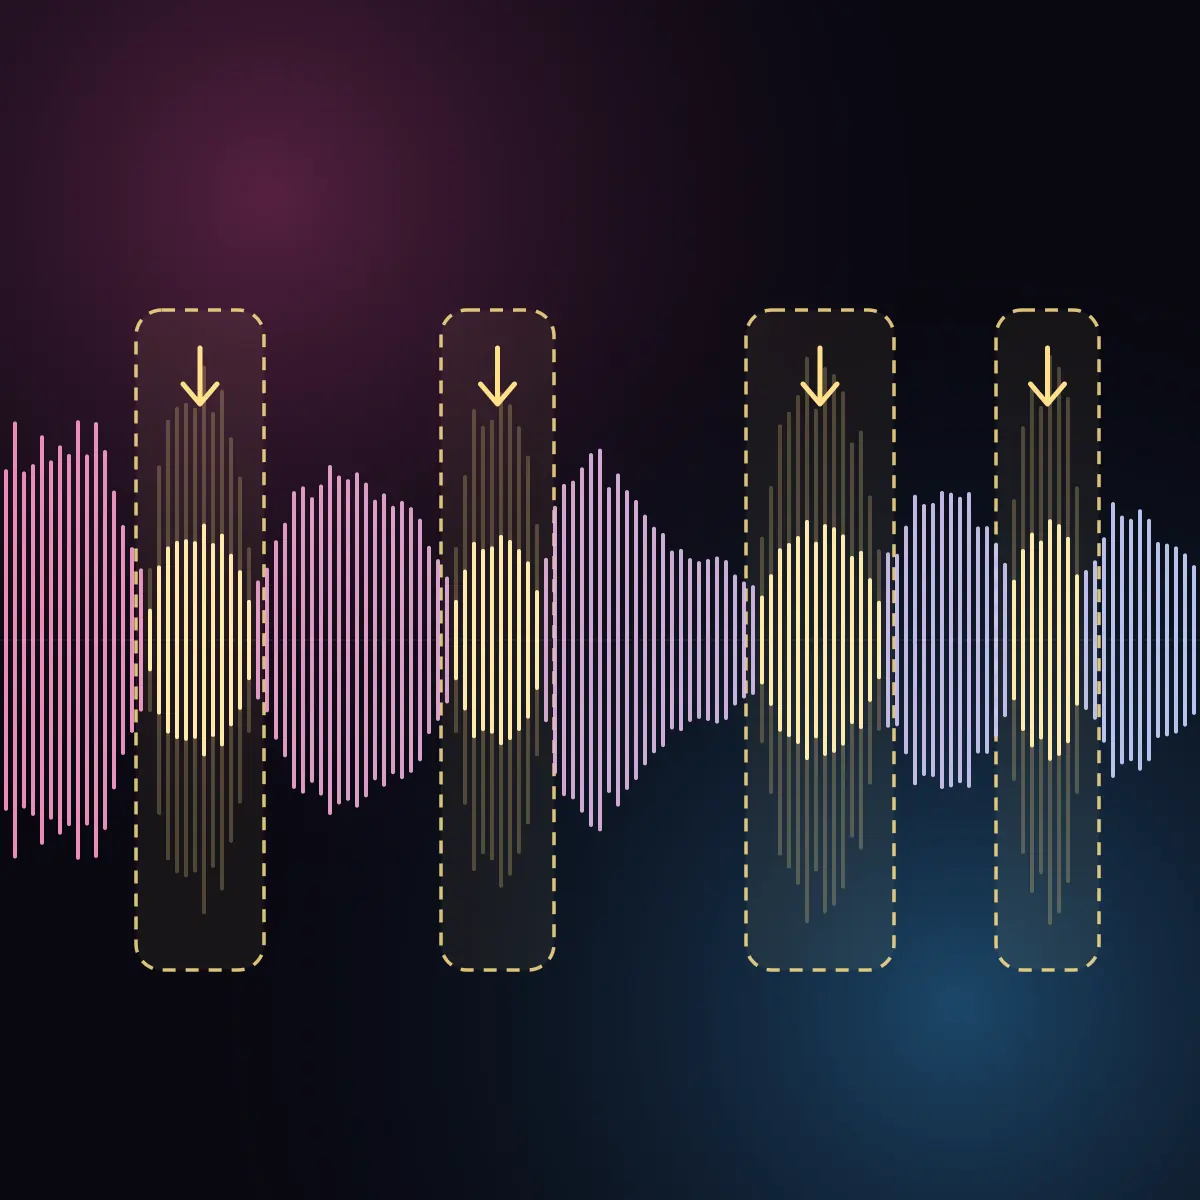
El De-Esser compara cada «s» con la voz que la rodea. Una estrofa suave y un estribillo fuerte reciben el mismo tratamiento, y no tienes que ajustar ningún umbral.
Herramienta de audio gratis
Sube una voz, un podcast o una locución. El De-Esser atenúa las «s», «ch» y «z» estridentes, y el resto de la voz conserva su timbre. Compara cada archivo con el original y después descarga el WAV.
De-Esser
Funciona con voces principales, coros, rap, podcasts, locución y voz hablada. Cada archivo vuelve en WAV a su propia frecuencia de muestreo.
El De-Esser compara cada «s» con la voz que la rodea. Una estrofa suave y un estribillo fuerte reciben el mismo tratamiento, y no tienes que ajustar ningún umbral.
Una «s» suave recibe un recorte pequeño. Una «s» que suena estridente frente a las vocales anteriores recibe un recorte mayor, en los agudos, que es donde está la estridencia.
Cada archivo tiene su propio reproductor. Cambia entre el original y la versión procesada mientras suena, y mira dónde se atenuó cada «s».
Un micrófono brillante, una toma muy cercana, un compresor o un realce de agudos pueden volver hirientes las «s», «ch» y «z». Un ecualizador que las recorta también apaga toda la voz. El De-Esser baja los agudos solo mientras dura uno de esos sonidos.
Suaviza la sibilancia de una voz principal o de los coros antes de la mezcla.
Haz que la voz hablada se escuche con más comodidad, también con auriculares.
Pasa primero las pistas de voz por el de-esser. Después puedes comprimirlas y darles brillo sin eses hirientes.
Elige Suave, Medio o Fuerte y añade hasta 5 archivos por sesión. Cada archivo puede durar hasta 20 minutos.
El De-Esser analiza cada archivo mil veces por segundo, encuentra las «s» y baja los agudos mientras dura cada una.
Reproduce cada archivo, cambia entre el original y la versión procesada y descarga el WAV.
Cada archivo vuelve en WAV con la misma duración, frecuencia de muestreo y canales que el archivo que subiste.
Qué hace, qué archivos acepta y cuáles son sus límites.
Atenúa la sibilancia: las «s», «ch» y «z» hirientes de una voz. Recorta los agudos de la voz solo mientras dura uno de esos sonidos, así que la voz conserva su brillo.
Una voz sola en su pista: voces principales, coros, rap, podcasts, locución y voz hablada. WAV, AIFF, FLAC, MP3, M4A y otros formatos de audio habituales, de hasta 20 minutos y 1 GB cada uno, con una frecuencia de muestreo de 32 kHz o más.
Empieza con Medio. Elige Suave para una voz que necesita solo un poco. Elige Fuerte para una voz brillante o muy comprimida, con eses hirientes. Un mismo ajuste se aplica a todos los archivos de una sesión.
El De-Esser está hecho para una voz sola en su pista. En una canción completa también atenúa los platillos, los hi-hats y otros sonidos brillantes. Si es una canción, pasa la pista de voz por el de-esser antes de la mezcla.
Los agudos de la voz mientras dura una «s», y un instante después. Las vocales y el cuerpo de la voz quedan como están. El archivo mantiene su duración, su frecuencia de muestreo y sus canales.
El De-Esser recorta solo mientras dura una «s», así que la voz sigue brillante entre una y otra. Si las eses quedan demasiado blandas, usa un ajuste más suave.
Una sesión por semana, con hasta 5 archivos en la sesión. No hace falta cuenta. Un plan de pago quita el límite semanal.
Un archivo WAV a la frecuencia de muestreo del archivo que subiste: 24 bits, o 32-bit float si tu archivo es de coma flotante. El reproductor de la página usa una vista previa AAC a 256 kbps. La descarga es el archivo en calidad completa.
Sube tus archivos, escucha la diferencia y descarga el WAV procesado.